Next.js Blog Template: Markdown, Live-Demos und JSON-LD
Ein typisches Next.js Blog Template bringt einen Ordner mit Markdown-Dateien, eine [slug]-Route und Tailwind Typography mit. Damit hast du eine Seite. Du hast damit aber keine strukturierten Daten, keine Feeds, kein Inhaltsverzeichnis, das auf dem Smartphone funktioniert, keine Entwürfe, die aus der Produktion draußen bleiben, und keine Prüfung, die verhindert, dass zwei Beiträge um dieselbe Suche konkurrieren. Dieses Build-Log zeigt, wie wir den Blog von Wingo UI mit Next.js 16 und unseren eigenen Vorlagen gebaut haben, welche Entscheidungen dahinterstehen und welche Regeln ein Skript jetzt bei jedem Beitrag durchsetzt, auch bei diesem.
Was braucht ein Next.js Blog Template außer einer [slug]-Route?
Es braucht die Teile, die einen Beitrag überall auffindbar und lesbar machen: strukturierte Daten, Feeds, ein Inhaltsverzeichnis, das auf dem Smartphone funktioniert, und Prüfungen, die laufen, bevor ein Beitrag live geht. Die üblichen Starter haben sie nicht. Das Blog Starter Kit von Vercel (opens in a new tab) (Vorlagenseite geprüft am 16. Oktober 2026) liest Markdown aus einem _posts-Ordner, parst das Frontmatter mit gray-matter, macht aus Markdown mit remark und remark-html HTML und stylt es mit Tailwind CSS. Auf der Vorlagenseite stehen weder Inhaltsverzeichnis noch JSON-LD, RSS oder Sitemap. Es ist ein sauberer Ausgangspunkt, und wenn du bis heute Abend einen persönlichen Blog willst, bist du damit schneller.
Unsere Liste war länger, denn der Blog ist zugleich eine Verkaufsdemo für unsere Vorlage Blog Page und die Vorlage Blog Post Page:
- Der komplette Artikel im Server-HTML: Titel, TL;DR, Text, FAQ, Autor und Datum, lesbar mit
curl. - Interaktive Live-Demos von Komponenten mitten im Text.
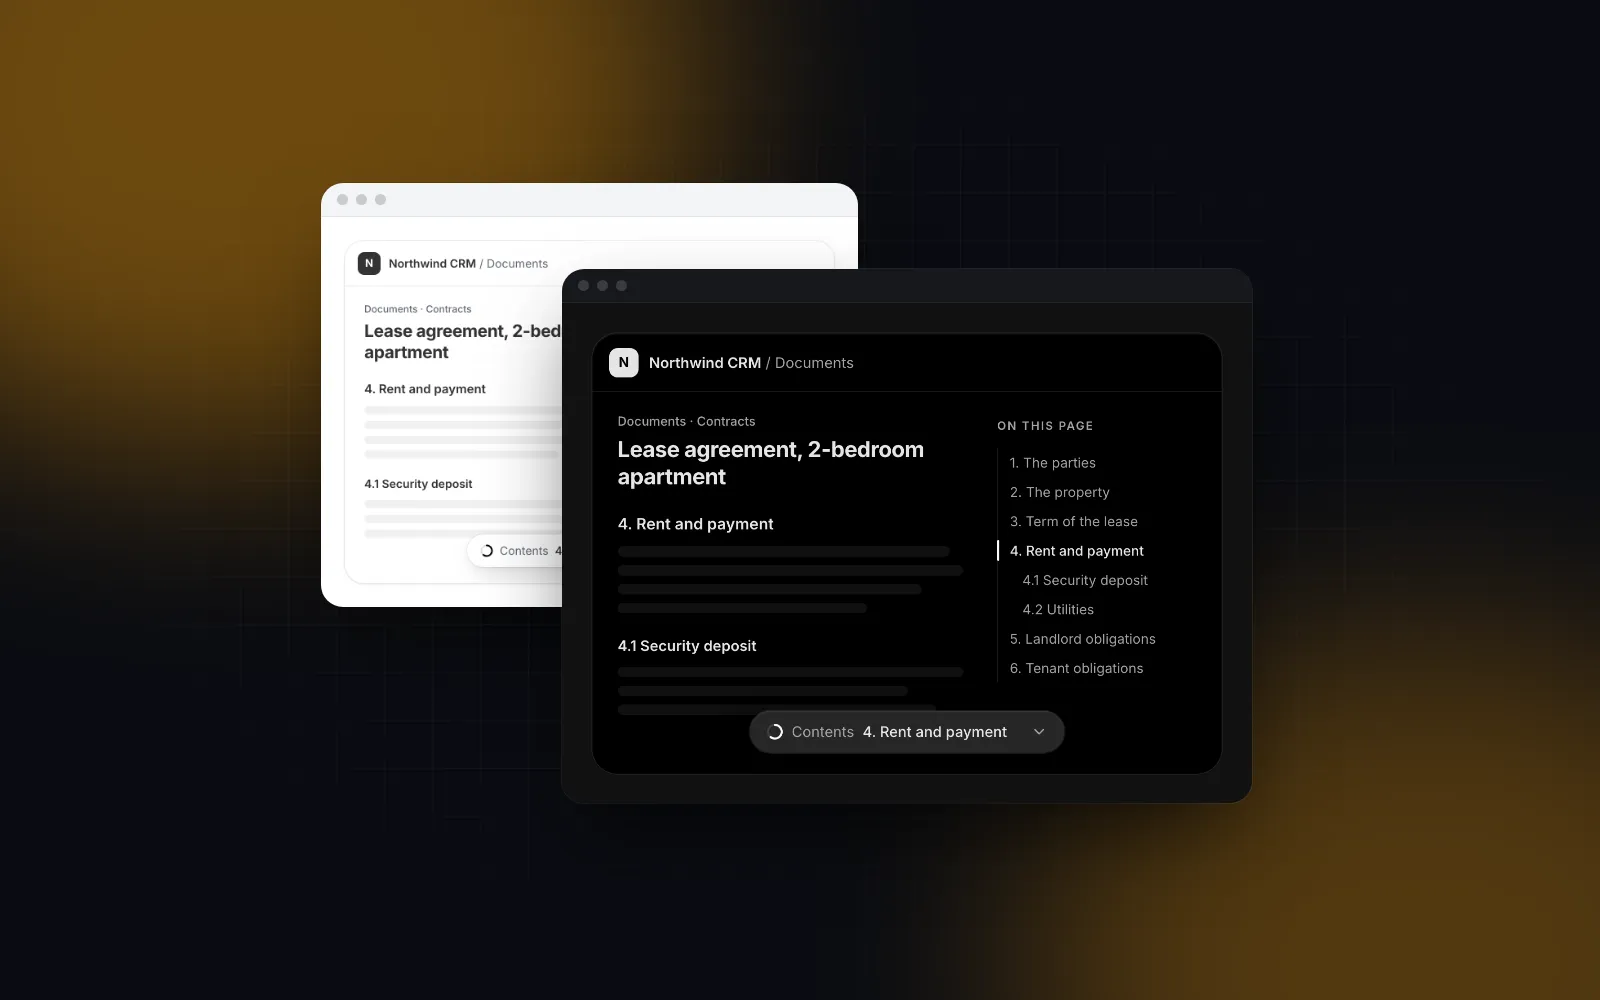
- Ein Inhaltsverzeichnis, das auf dem Desktop neben dem Artikel klebt und auf dem Smartphone zum Bottom Sheet wird.
- JSON-LD für
BlogPosting,FAQPageundBreadcrumbList, Open-Graph-Bilder, eine Sitemap. - RSS, ein JSON Feed und eine Markdown-Version jedes Beitrags für KI-Agenten.
- Ein Validator, der CI scheitern lässt, wenn ein Beitrag gegen die Regeln verstößt.
Warum einfache Markdown-Dateien statt MDX?
Weil jeder Beitrag an vier Stellen als Text existieren muss: in der HTML-Seite, im RSS-Eintrag, in der .md-Version und in llms-full.txt. Bei den meisten Setups für Next.js Blog MDX darf ein Beitrag jede React-Komponente importieren. Beliebiges JSX hat aber keine Textform, also bräuchte jeder Import an drei dieser vier Stellen einen handgeschriebenen Ersatz.
Wir haben deshalb einen Next.js Markdown Blog im strengen Sinn gebaut, ohne JSX in Beiträgen. Beiträge sind Dateien unter content/blog/posts/<slug>.md, der Dateiname ist der Slug, und das Frontmatter läuft beim Laden der Beiträge durch ein zod-Schema. Ein fehlerhaftes Feld lässt den Build mit Dateiname und Feld scheitern, statt in der Produktion eine leere Beschreibung zu rendern. Das hier ist eine gekürzte Kopie des echten Schemas:
Zwei Details sind wichtig. YAML macht aus einem 2026-10-16 ohne Anführungszeichen ein JavaScript-Date, also wandelt dateField es zurück in den reinen Tag, bevor der Regex läuft. Ohne das scheitert jedes Datum ohne Anführungszeichen mit „expected string“. Und .strict() lehnt unbekannte Schlüssel ab. Das fängt Tippfehler wie tdlr, die sonst still verschwinden würden. Wir parsen mit dem Paket yaml und einem kleinen Regex für die ----Begrenzungen, deshalb brauchen wir gray-matter nicht.
Wie funktionieren Live-Demos von Komponenten in einem Markdown-Beitrag?
Embeds nutzen die einzige Markdown-Syntax, die ohnehin auf externe Inhalte zeigt: das Bild. Ein Beitrag enthält , und der Loader sammelt jeden solchen Link ein (Code-Blöcke überspringt er) und prüft, ob der Slug in der Registry existiert. Optionale Playground-Werte reisen als URL-kodiertes JSON in ?values= mit, und &h= reserviert die Höhe des Rahmens, begrenzt auf 160 bis 900px. Ohne diesen Wert bekommt eine Komponenten-Demo 360px und ein Block oder eine Vorlage 640px. So verschiebt sich nichts, wenn die Demo lädt.
Die Vorlage Blog Post Page hat eine Prop figures, die eine Quelle #figure-<name> auf einen beliebigen React-Knoten abbildet. Die Website füllt diese Map für jeden Link mit einer Demo-Abbildung: die echte Demo aus der Registry, die Bildunterschrift und eine Installationsleiste mit dem CLI-Befehl, einem Free- oder Pro-Badge und einem Link zur Doku. Ein Absatz, der nur eine Abbildung enthält, wird als div gerendert, denn eine Demo in einem <p> ist ungültiges HTML, und React warnt bei der Hydration davor.
Jede Demo wird erst gemountet, wenn ihre Box bis auf 400px an den Viewport herankommt. Das erledigt ein IntersectionObserver. Ein Beitrag mit drei Demos lädt also einen Chunk nach dem anderen. Blöcke und Vorlagen rendern stattdessen in einem Same-Origin-Iframe von /preview/<slug>. So bleiben ihre Sticky Header aus dem Artikel heraus, und ihre Media Queries richten sich nach der Breite des Rahmens statt nach dem Fenster. Hier läuft die Vorlage für die Beitragsseite selbst, mitten in diesem Beitrag:
$ npx wingo-ui@latest add blog-post-pageDer Text um eine Demo herum muss für sich allein verständlich sein. Crawler, Feed-Reader und KI-Assistenten führen kein JavaScript aus. Deshalb ersetzt die .md-Version jede Abbildung durch eine Zeile, die die Komponente nennt, auf ihre Doku verlinkt und den Installationsbefehl angibt.
Wie baust du in einen Next.js-Blog ein Inhaltsverzeichnis ein, das auf dem Smartphone funktioniert?
Erzeuge das Inhaltsverzeichnis und die IDs der Überschriften mit derselben Slug-Funktion, und rendere die Desktop-Liste und die Pill fürs Smartphone auf dem Server. Der klassische Fehler, wenn du ein Next.js Blog Inhaltsverzeichnis baust, ist ein Link auf eine ID, die die gerenderte Überschrift gar nicht hat. Deshalb nutzen wir an beiden Stellen eine einzige Funktion. Die Komponente Markdown hat eine Prop headingIds, die jeder Überschrift eine ID aus slugifyHeading gibt, und markdownToc(source) aus der Vorlage liest die h2- und h3-Zeilen derselben Quelle mit derselben Funktion und hängt bei Duplikaten -2 an. Die Website hängt die FAQ aus dem Frontmatter vor dem Rendern als Abschnitt ## FAQ an den Text, damit sie auch im Inhaltsverzeichnis auftaucht.
Die Liste geht an die Komponente Table Of Contents. Auf dem Desktop klebt sie neben dem Artikel und markiert den Abschnitt, den du gerade liest. Unterhalb von collapseBelow wird sie zu einer Pill, die unter dem Header festsitzt und ein Bottom Sheet mit 48px hohen Zeilen öffnet. Beide Layouts stehen im Server-HTML, und der Wechsel ist reines CSS. Ein Smartphone sieht also nie zuerst kurz die Desktop-Liste aufblitzen. So sieht die Verdrahtung in einer Client-Komponente aus:
Der Sticky-Abstand kommt aus der CSS-Variable --topbar-offset. Der Header unserer Website ist 56px hoch, also setzt die Beitragsansicht sie auf calc(56px + env(safe-area-inset-top)). So landen angesprungene Überschriften auf einem iPhone mit Notch direkt unter dem Header.
$ npx wingo-ui@latest add table-of-contentsWie sieht Next.js Blog SEO auf jeder Beitragsseite aus?
Jede Beitragsseite ist statisches HTML mit vollständigen Metadaten und einem JSON-LD-Graphen. Der größte Teil von Next.js Blog SEO besteht darin, diese langweiligen Teile auf jeder Seite ohne Ausnahme zu erledigen. Die Route ist statisch: generateStaticParams gibt die veröffentlichten Slugs zurück, und dynamicParams = false macht aus jedem anderen Slug einen 404. generateMetadata liefert Titel, Beschreibung, eine Canonical-URL, Open Graph type: article mit Veröffentlichungs- und Änderungszeit, eine Twitter Card summary_large_image und einen Alternate-Link auf die .md-Version.
Beim JSON-LD folgen wir dem JSON-LD-Guide von Next.js (opens in a new tab): ein <script type="application/ld+json"> in der Seite, bei dem < durch \u003c ersetzt wird, damit ein Beitragstitel den Script-Tag nie schließen kann. Ein Graph pro Beitrag enthält ein BlogPosting (Headline, Datum, Autor als Person mit Link auf die Autorenseite, keywords, wordCount und mentions, mit jeder Komponente als SoftwareSourceCode, die auf ihre Doku zeigt) und ein FAQPage aus derselben FAQ, die auch auf der Seite steht. Die BreadcrumbList kommt aus der sichtbaren Breadcrumb-Komponente, also können Markup und Seite nicht auseinanderlaufen. Google zeigt laut seinem Search-Central-Changelog (opens in a new tab) (geprüft am 16. Oktober 2026) seit dem 7. Mai 2026 keine FAQ-Rich-Results mehr. Wir haben die FAQ trotzdem behalten: Diesen Teil eines Beitrags zitiert ein Assistent am ehesten.
Ein Stolperstein wird leicht übersehen. Unter einer Route Group hängt Next.js an eine opengraph-image-Route ein Suffix: die ersten sechs Base-36-Zeichen eines djb2-Hashs des Elternpfads. Die <meta>-Tags bekommen die richtige URL automatisch, das image im JSON-LD aber nicht. Deshalb berechnet seo.ts denselben Hash, um eine passende URL zu bauen. Wenn du die Route verschiebst, ändern sich beide gemeinsam.
Wie entstehen Feeds und Markdown-Versionen aus denselben Dateien?
Alles läuft über einen einzigen Loader, getPosts(), der nach Datum sortiert und Entwürfe in Produktions-Builds weglässt. Der RSS-2.0-Feed unter /blog/rss.xml und der JSON Feed 1.1 unter /blog/feed.json listen die neuesten 50 Beiträge, und die neuesten 20 enthalten den kompletten Artikel als HTML, gerendert mit remark-gfm und remark-rehype aus demselben Markdown. Die Beiträge 21 bis 50 bekommen trotzdem einen Eintrag mit ihrer Zusammenfassung. Erscheinen viele Beiträge am selben Tag, fällt so keiner aus dem Feed.
Jeder Beitrag ist außerdem als Markdown unter seiner URL plus .md erreichbar, über ein Rewrite von /blog/:slug.md auf einen Route Handler. Das ist dasselbe Muster wie in unserem Tutorial zu Next.js llms.txt. llms.txt listet jeden Beitrag mit seinem .md-Link, und llms-full.txt hängt die Beiträge vollständig an, mit Überschriften, die um zwei Ebenen nach unten verschoben sind, damit sie unter einem Abschnitt ## Blog stehen.
Wie verhindert der Validator Keyword-Kannibalisierung?
Er lässt den Build scheitern, wenn zwei Beiträge dasselbe primäre keyword angeben. npm run blog:check läuft in CI nach dem Registry-Check, und auch der Loader wirft bei einem Duplikat einen Fehler. Zwei Seiten, die auf dieselbe Suche zielen, teilen sich nämlich die Klicks und die Links. Außerdem verlangt der Validator das Keyword im Titel, in der Beschreibung, im Slug und in den ersten 100 Wörtern.
Die übrigen Fehler fangen die Patzer ab, die in einem Markdown-Repo leicht passieren:
- Weniger als 3 Links auf
/components/*-Seiten oder kein Link hoch zur Kategorieseite oder zum Pillar-Beitrag. - Ein interner Link auf eine Route, die es nicht gibt, ein veröffentlichter Beitrag, der auf einen Entwurf verlinkt, oder ein Link auf
/components/<template>, der weiterleitet (der Check verlangt/templates/<slug>). - Ein
h1im Text, ein Bild ohne Alt-Text, ein unbekannter Komponenten-Slug, irgendwo ein Geviertstrich. - Eine veraltete
published.generated.ts. Client-Komponenten könnencontent/blognicht lesen, also schreibt ein SkriptHAS_PUBLISHED_POSTSin eine Datei, die der Header liest. Der Blog-Link bleibt versteckt, bis es einen echten Beitrag gibt.
Warnungen gibt es für die Wortzahl pro Beitragstyp, eine fehlende Demo, ein sekundäres Keyword, das im Text fehlt, und ein updated-Datum, das älter als 12 Monate ist.
Welche Kompromisse hat ein Markdown-Blog in Next.js?
Ein Markdown-Blog hat zwei echte Kosten: kein eigenes React außerhalb der Abbildungs-Syntax und eine harte Trennung zwischen Server und Client. Die Regel „nur Markdown“ heißt, dass ein Beitrag keine einmalige Komponente enthalten kann. Wenn wir ein Diagramm wollen, muss es zuerst eine Registry-Demo werden, und das ist mehr Arbeit als ein MDX-Import. Wir nehmen das hin, weil dann jedes Embed eine dokumentierte, installierbare Komponente ist und die .md-Version ehrlich bleibt.
Die Client-Grenze war der andere Preis. Die Vorlage nimmt Funktionen als Props an, etwa onSubscribe für das Newsletter-Formular, und ihre figures-Map enthält Client-Demos. Funktionen können nicht von einer Server-Komponente in eine Client-Komponente wandern. Deshalb ist die Beitragsseite eine Server-Route, die den Beitrag lädt, das JSON-LD und die Breadcrumb rendert und reine Daten an eine kleine Client-Ansicht weitergibt. Jede Doku-Seite listet außerdem die Beiträge, die ihre Komponente nutzen, serverseitig gerendert. Das verlinkt Blog und Katalog in beide Richtungen. Weitere Screens aus dieser Kategorie findest du unter Praxis: Screens und Apps und im Tutorial zum Next.js Admin Dashboard, das fünf Admin-Screens aus Blöcken von Wingo UI baut.
Wie starte ich meinen eigenen Blog mit diesen Vorlagen?
Installier die Beitragsseite mit der CLI. Sie bringt die Blog-Übersicht, die Komponente Breadcrumb und das Inhaltsverzeichnis mit:
BlogPostPage nimmt Funktionen und eine Router-Link-Komponente an, gehört also in eine Client-Komponente. Die Server-Route liest das Markdown und reicht reine Daten nach unten:
Drei Standardwerte sorgen bei der ersten Installation für Überraschungen. relatedPosts und categories nutzen standardmäßig die Acme-Beispieldaten. Ein echter Beitrag zeigt also drei erfundene verwandte Karten, bis du eigene übergibst oder sie abschaltest. Ohne onSubscribe wartet das Newsletter-Formular 900 ms und meldet Erfolg, ohne etwas zu senden. Und die Vorlage zeichnet ihren eigenen Marketing-Header und -Footer. Setz also header={false} und footer={false}, wenn die Seite im Layout deiner Website sitzt, so wie bei uns.
Die drei Blog-Bausteine gehören zu Pro, siehe Preise. Wenn du mit Claude Code oder Cursor baust, kann der MCP-Server von Wingo UI die Props für deinen Agenten nachschlagen, während er die Seiten verdrahtet.
Häufige Fragen
Sollte ein Next.js-Blog MDX oder einfaches Markdown nutzen?
Nimm MDX, wenn Autorinnen und Autoren beliebiges React in Beiträgen brauchen. Nimm einfaches Markdown mit einer kleinen Konvention für Embeds, wenn Beiträge als Text lesbar bleiben sollen, für Feeds, .md-Seiten und KI-Agenten. Deshalb haben wir uns für Markdown entschieden.
Wie baue ich ein Inhaltsverzeichnis in einen Next.js-Markdown-Blog ein?
Lies die h2- und h3-Zeilen aus dem Markdown, gib jeder dieselbe Slug-ID, die dein Renderer auf die Überschrift setzt, und reich die Liste an eine Inhaltsverzeichnis-Komponente weiter. Die Blog Post Page von Wingo UI macht das mit markdownToc und der Markdown-Prop headingIds, deshalb passen die IDs immer.
Braucht ein Next.js-Blog JSON-LD?
Es ist optional, aber ein BlogPosting-Knoten mit Headline, Datum, Autor und Bild beschreibt den Artikel für Suchmaschinen und andere Leser an einer Stelle. Der JSON-LD-Guide von Next.js empfiehlt ein Script-Tag in der Seite und rät, das Zeichen < zu escapen, damit die Daten den Tag nie schließen können.
Lohnt sich FAQPage-Markup noch?
Google zeigt laut dem Search-Central-Changelog seit dem 7. Mai 2026 keine FAQ-Rich-Results mehr. Wir rendern trotzdem eine sichtbare FAQ und ihren FAQPage-Knoten, weil die Antworten zum Zitieren geschrieben sind und das Markup nur einen Funktionsaufruf kostet.
Sind die Blog-Vorlagen von Wingo UI kostenlos?
Blog Page, Blog Post Page und Table Of Contents gehören Stand Oktober 2026 zu Pro. Installier sie mit npx wingo-ui@latest add blog-post-page, das holt auch die Blog Page und das Inhaltsverzeichnis mit.
- Next.js
- Blog
- Markdown
- SEO
- JSON-LD
- Vorlagen